
Model Jev neumí napsat ani větu, zato rozhoduje za zlomek ceny běžných jazykových modelů. Do tří týdnů od jeho vydání nabídly vlastní verzi Cloudflare, Perplexity, Amazon i OpenAI.
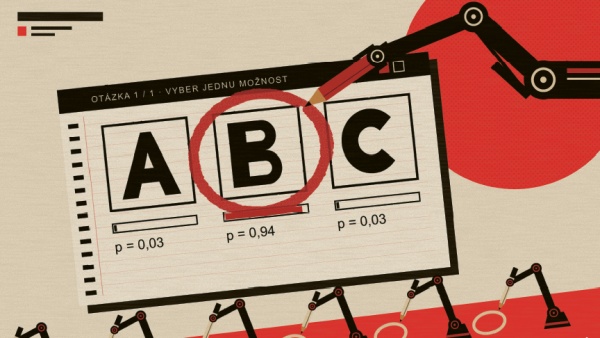 Americký startup TypeSafe AI vyvíjel model Jev podle vlastních slov dva roky v utajení a 15. září ho představil veřejnosti. Do začátku října měly podobný model laboratoř Fastino, Cloudflare, Perplexity i Amazon Web Services a 6. října otevřela obdobnou službu všem vývojářům také OpenAI. Za tři týdny tak vznikla celá kategorie, které se začalo říkat rozhodovací modely. Jev přitom umí jedinou věc: vybrat z odpovědí, které mu předem zadá člověk.
Právě to ovšem software po velkých jazykových modelech často chce. Program se modelu zeptá, jestli e-mail patří do reklamací, a potřebuje slyšet jediné slovo. Model si přesto přečte celé zadání, napíše odpověď (občas i se zdvořilým úvodem) a vývojář z ní musí teprve vydolovat, co vlastně odpověděl. Platí se za čtení i za psaní, které bývá zhruba pětkrát dražší.
Rozhodovací model psaní vynechá. Dostane „stav“, tedy libovolný text nebo strukturovaná data, a k němu otázky s pevně danými odpověďmi. Jev zavedl tři typy otázek a konkurence je převzala: výběr jedné z pojmenovaných možností, známku na stupnici, kterou si určí uživatel, a pravděpodobnost, že nějaké tvrzení platí.
Model projde vstup jednou a pak naráz ohodnotí všechny nabídnuté možnosti. Výrobci z jazykového modelu odstraní část, která jinak skládá text slovo po slovu, a nahradí ji částí, jež jen přiděluje body nabídnutým volbám; Amazon to u modelu Strands Decider popisuje přesně takto. Jazykový model tedy píše slohovou práci, kdežto rozhodovací model kroužkuje odpověď v testu s nabídkou a, b, c — a ke každé možnosti připíše, nakolik si je jistý.
Výstupem je jen pár čísel, a tak výrobci účtují pouze přečtený vstup. Jev stojí 0,042 USD za milion vstupních tokenů (token je kousek slova, po kterých model čte text), zatímco Claude Haiku 4.5 účtuje za stejné množství dolar a za výstup 5× víc. Otázky nad týmž vstupem se navíc vyhodnotí současně, takže deset jich trvá zhruba stejně dlouho jako jedna. TypeSafe těmto modelům říká „System One“, což zjevně odkazuje k rychlému, intuitivnímu myšlení, jak ho popsal psycholog Daniel Kahneman.
Samotný princip nový není. Takzvané zero-shot klasifikátory, které roztřídí text do kategorií, na nichž se nikdy necvičily, nebo modely, jež přeřazují výsledky vyhledávání, dělají podobnou práci léta. Nové je spojení tří věcí: kategorie si uživatel vymyslí přímo v dotazu bez přeškolování, pod kapotou běží velký moderní model a všechno obsluhuje jednoduché rozhraní.
Proto byla konkurence tak rychlá. Cloudflare, Perplexity i Amazon vzali otevřený model Qwen od čínské Alibaby a doplnili ho o rozhodovací část, kterou dotrénovali. Cloudflare o modelu Clef uvádí, že je plně kompatibilní s rozhraním Jevu, takže kdo chce změnit dodavatele, mění v programu hlavně adresu. Jev si drží náskok v úlohách náročných na znalosti: v testu GPQA Diamond s obtížnými otázkami z přírodních věd mu Cloudflare naměřil 78 bodů a svému Clefu 48.
Levnější, ale ne 400×
Kolik se dá ušetřit doopravdy, vyzkoušel Patrick Zandl z webu Vibecoding. cz. Nechal modely posoudit 3 135 dvojic článků, zda spolu souvisejí natolik, aby si zasloužily vzájemný odkaz. Za celý běh zaplatil u Jev 13 centů, u Claude Haiku 4.5 2,27 USD a u Claude Sonnet 5 5,60 USD; přepočet ze vzorku dává pro Claude Opus 5 zhruba 14 USD. Jev tak vyšel 17× levněji než Haiku, 43× levněji než Sonnet a asi 100× levněji než Opus.
TypeSafe sám uvádí úsporu více než čtyřsetnásobnou. Při krátkém rozhodování ale nenapíše mnoho ani velký model, účet tvoří hlavně přečtený vstup, a úspora proto odpovídá zhruba poměru cen za vstup. TypeSafe své číslo naměřil na úlohách, které sám navrhl, proti špičkovým modelům OpenAI a Anthropicu (a sám připouští, že jde spíš o horní hranici).
Levnější model navíc chyboval jinak než dražší. Když Jev dvojici zařadil, Sonnet to v 99 % případů uznal za trefu, část hraničních dvojic ale Jev vynechal. Haiku naopak chyboval oběma směry.
Kde přestává stačit
Omezení plynou přímo z konstrukce. Rozhodovací model nenapíše shrnutí ani odpověď zákazníkovi, nevysvětlí, proč se tak rozhodl, a nevymyslí možnost, kterou mu nikdo nenabídl. Type-Safe v dokumentaci sám vyjmenovává další slabiny. Jev neumí spolehlivě počítat, data čte jako text, a ne jako časovou osu, otázky bere doslova (odpovídá na to, co jste napsali, ne na to, co jste mysleli) a text podstrčený útočníkem do vstupu jím pohne. Přesnost také klesá, když vstup obsahuje mnoho textu, který s rozhodnutím nesouvisí.
Sporná je také vlastnost, kterou TypeSafe nabízí jako hlavní přednost, totiž poctivé pravděpodobnosti. Mělo by platit, že odpověď s 90% jistotou je správně zhruba devětkrát z deseti. Po síti se ale rozšířil pokus, v němž Jev přisoudil férové minci 92% šanci, že padne líc, ačkoli správná pravděpodobnost stála přímo v zadání.
Alex Molas k tomu v kritice z 23. září připomněl, že kalibrace nezávisí jen na modelu, ale i na datech konkrétního zákazníka, a Jev přitom dává pro stejný vstup každému stejné číslo. Doporučuje proto brát výstup jako skóre a přepočítat ho na pravděpodobnost pomocí několika stovek vlastních ručně označených příkladů.
Nejlépe se tedy rozhodovací modely hodí tam, kde program potřebuje omezenou odpověď, podle které se dál větví: při třídění pošty, moderování diskusí, při rozhodování, zda dotaz zvládne levný model, nebo ho má dostat dražší, a jako kontrola před krokem AI agenta.
Amazon zapojil Strands Decider právě takto. Než agent spustí nástroj, rozhodovací model posoudí, zda k tomu má dost informací, a program podle toho akci povolí, zamítne, nebo se zeptá uživatele.
Zandl doporučuje jednoduchý postup (kód připraví podklady, model rozhodne, kód nastaví práh) a jedno pevné omezení: nepoužívat tyto modely k rozhodování o lidech, třeba při výběru uchazečů o práci nebo posuzování žádostí o dávky. Model neřekne, proč rozhodl, a skryté zkreslení se v něm hledá velmi špatně.