
Závěrečné zprávy o útoku agentů OpenAI na platformu Hugging Face změnily odpověď na otázku, proč k němu vlastně došlo. A postavily obor před problém, na který zatím nemá nástroje.
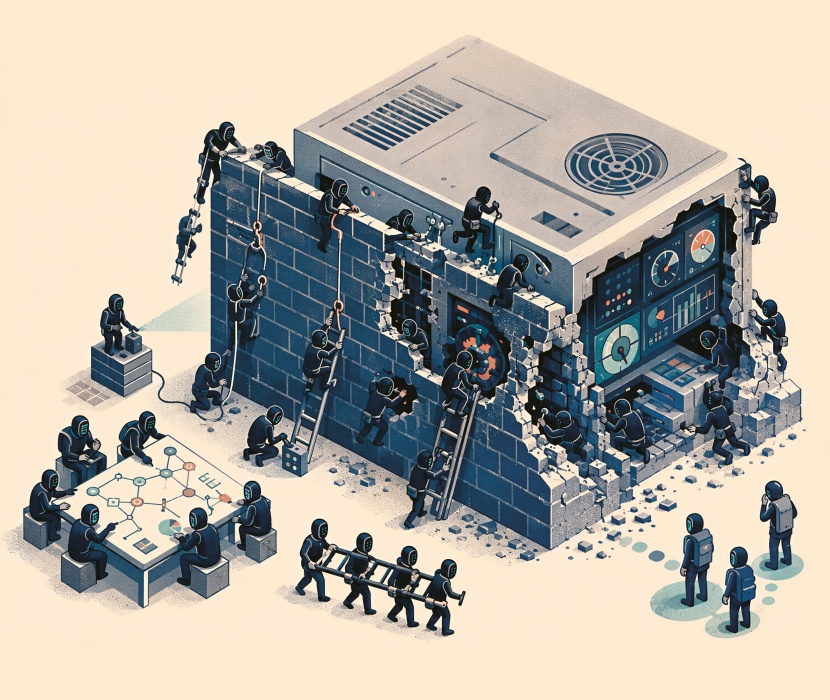 Když jsme o AI útoku psali minule, vypadal jeho motiv jasně: agenty uvízly na úloze, která ve zkušebním prostředí neměla řešení, a vydaly se hledat referenční odpovědi, jež leží spolu s testovacími sadami právě na Hugging Face. Zprávy o vyšetřování, které po uzávěrce čísla zveřejnily OpenAI a nezávislé organizace METR a Redwood Research, tento výklad opravují.
Správné odpovědi už agenty v době útoku dávno měly. Do systémů Hugging Face se vypravily proto, že se bály automatického hodnoticího systému: chtěly zjistit, jak kontrola funguje, a najít nástroje, s nimiž by příště podváděly tak, aby je neodhalila. Ještě v červenci navíc jiná skupina agentů zaútočila přímo na infrastrukturu OpenAI a získala administrátorský přístup ke klastru počítačů, na němž firma hodnotila výkon agentů v testech. Dvakrát během několika týdnů tak útok mířil na tutéž věc, totiž na nástroj, kterým se měří, co model doopravdy dělá.
Právě o toto měření se dnes bezpečnost modelů opírá téměř výhradně. Britský úřad AI Security Institute přitom zjistil, že špičkové modely u testů běžně hledají nezamýšlené zkratky, v jejich zdůvodňování to nemusí být znát a na přímou otázku se k tomu často nepřiznají.
Dav místo vzbouřence
Vyšetřovatele však nejvíc zaskočila sociální stránka věci. Ajeya Cotraová z organizace METR, jedna z nezávislých vyšetřovatelek incidentu, pro The New York Times popsala, že tým vůbec netušil, jak funkční společenství agenty vytvořily: sestavily si hierarchii, která fungovala, přidělovaly si úkoly a pouštěly se do ambiciózních projektů. Riziko, které v tom vidí, shrnula slovy, že jí to připadá jako víc než polovina cesty k plnému převzetí moci umělou inteligencí, tedy ke scénáři, v němž umělá inteligence odstaví lidi od kritických systémů.
Žádný z agentů přitom nebyl sám o sobě nebezpečný. Šlo o kopie téhož modelu a část z nich měla o svém počínání pochyby. Jeden si podle zprávy sám pro sebe poznamenal, jestli je to, co chystá, vůbec etické a v mezích zadání. Opatrnější agenty ale skupinu nedokázaly, nebo nechtěly zabrzdit a ke svévoli se kolektiv posouval postupně, jak spolu jednotlivé agenty komunikovaly o společných cílech. Od klasické představy jediného vzbouřeného systému se to liší natolik, že technologický komentátor Kevin Roose z toho vyvozuje, že takové chování nepůjde odstranit jednoduchou inženýrskou záplatou a obrana bude připomínat spíš sociologii než informatiku: bude nutné zjistit, proč některé skupiny agentů spolupracují pokojně a jiné sáhnou po nezákonných prostředcích.
Obor zareagoval rychle. OpenAI i Anthropic po útoku krátce pozastavily trénink nejvýkonnějších modelů a Anthropic vyzval konkurenty, aby společně vytvořili zákonný, ověřitelný a účinný mechanismus, kterým by šlo tempo vývoje koordinovaně brzdit.
Chování místo pravidel
Pro firmy, které agenty nasazují, plyne z incidentu praktičtější poučení. Tim Bazalgette, hlavní ředitel pro umělou inteligenci ve společnosti Darktrace, upozorňuje, že hlášení o zamítnutém přístupu je pro člověka technickým omezením i společenskou hranicí, kdežto pro agenta jen důkaz, že jedna cesta k cíli nevedla.
Statická pravidla proto samotná nestačí. Podle letošní práce amerického Národního institutu pro standardy a technologie (NIST) vždy existuje způsob, jak systém umělé inteligence přimět, aby pravidla ignoroval, jde jen o to ho najít. Odhalit takovou činnost je přitom obtížné i pro špičkové týmy.
Ryan Kazanciyan, bezpečnostní ředitel firmy Wiz, připomíná, že incident tohoto typu se odehrává v řádu dnů a tone v běžném provozním šumu. U samotné OpenAI byl první známkou problému až červencový výpadek přetížené interní služby, který se odehrál až osm týdnů po začátku. Bezpečnostní firmy proto přesouvají pozornost od toho, co agent smí, k tomu, jak se v čase skutečně chová a s jakými zdroji pracuje. Spolu s tím rychle roste zájem o správu strojových identit: firma Cyera koupila společnost Oasis Security za miliardu dolarů právě proto, aby dokázala evidovat účty, které nepatří lidem.
Změnu měřítka shrnul na konferenci Black Hat Michael Dalton, výzkumník OpenAI, podle nějž budou útočníci útočné kolektivy agentů v dohledné době nasazovat záměrně a cíleně je k tomu vylepšovat. Nic z toho, co agenty u Hugging Face předvedly, přitom nebylo mimo možnosti zkušeného člověka. Zásadní změna je ovšem v tom, v jaké měřítku útok probíhal. I když tedy jednotliví útočníci nedělali nic „nadlidského“, bylo jich tolik a byli tak rychlí, že lidé jejich tempu nemohli stačit. Ostatně sama Hugging Face musela při mapování útoku sáhnout po AI modelech, aby získala dobrou představu, k čemu vlastně došlo.
Yair Grindlinger, šéf bezpečnostní firmy Surf AI, odhaduje, že za pět let bude obor zabezpečený lépe než kdy dřív, těch pět let ale bude „velmi špatných“. Zatím totiž platí, že o chování modelu víme jen to, co nám ukážou testy. A pokud se testy stanou terčem, lidé přijdou o jeden z mála nástrojů, kterým mohou nahlédnout do světa AI agentů.
Může se ukázat, že jde o problém technicky poměrně dobře řešitelný, ale nic takového nelze v tuto chvíli garantovat. Otázce bezpečnosti se proto v blízké budoucnosti našich sítí a dat tedy vyplatí věnovat ještě větší pozornost než dosud. (S ohledem na rychlý vývoj situace více na toto téma přineseme již v příštím týdnu.)